Ahora Leyendo: Machine Learning y Deep Learning: diferencias que se entienden con ejemplos
-
01
Machine Learning y Deep Learning: diferencias que se entienden con ejemplos
Machine Learning y Deep Learning: diferencias que se entienden con ejemplos

De una tabla de ventas a una fotografía: cómo cambian los modelos, qué aprenden y qué pruebas permiten saber si funcionan con ejemplos nuevos.
Tabla de contenido
Una tienda quiere anticipar cuántos cuadernos venderá la próxima semana. Tiene una tabla con ventas, precios y fechas. Otra aplicación debe reconocer un cuaderno en una fotografía tomada con el teléfono. Ambas pueden usar aprendizaje automático, aunque sus datos y sus dificultades sean diferentes. La primera ya dispone de columnas que una persona puede interpretar; la segunda recibe una cuadrícula de píxeles.
La diferencia entre machine learning y deep learning empieza ahí: cómo representamos el problema y qué parte de esa representación aprende el sistema. Deep learning, o aprendizaje profundo, pertenece al machine learning, o aprendizaje automático. No son dos tecnologías rivales que debamos colocar en extremos opuestos. Una es una familia dentro de la otra.
Para entender qué implica esa relación conviene seguir un proyecto concreto, desde los ejemplos iniciales hasta la prueba con datos nuevos. El nombre del algoritmo ayuda a orientarse, pero no demuestra que una solución funcione. Una red enorme también puede aprender una pista equivocada con una eficiencia admirable.
Un mapa para ordenar las palabras: qué es deep learning
Inteligencia artificial es el término más amplio de este grupo. Incluye sistemas con reglas diseñadas por personas y sistemas que ajustan su comportamiento a partir de datos. El aprendizaje automático estudia métodos para encontrar regularidades aprovechables en ejemplos. Dentro de él encontramos redes neuronales, árboles de decisión y otros modelos.
El aprendizaje profundo utiliza redes neuronales con múltiples capas de transformación. La profundidad describe esa organización matemática; no mide lo inteligente que parece una respuesta. Tampoco existe una frontera universalmente útil que convierta una red en profunda al añadir exactamente cierta cantidad de capas.
Una forma de visualizarlo es imaginar carpetas incluidas unas dentro de otras. La carpeta de inteligencia artificial contiene la de aprendizaje automático. Esta contiene diferentes familias, entre ellas las redes neuronales; las redes profundas forman parte de esa familia. El mapa permite clasificar, aunque los proyectos reales suelen combinar métodos.
La explicación de IBM sobre aprendizaje automático presenta esa relación y su objetivo general: obtener resultados útiles con ejemplos que el sistema no ha visto. Esa última condición importa más que memorizar una definición. Si una herramienta solo responde correctamente a los casos usados para prepararla, todavía falta demostrar su utilidad.
Qué aprende una máquina cuando aprende
Supongamos que queremos estimar cuánto tardará una entrega. Reunimos pedidos anteriores con distancia, cantidad de paquetes y duración observada. Elegimos un modelo que combina esas entradas para producir una estimación. Durante el entrenamiento ajustamos sus parámetros buscando reducir una medida de error.
Un parámetro puede representar cuánto cambia la estimación al aumentar la distancia. En modelos más complejos, los parámetros no tienen una interpretación tan directa. En ambos casos, aprender significa modificar valores mediante un procedimiento definido. No exige atribuir al programa una experiencia humana de comprensión.
La función de pérdida expresa qué resultados queremos penalizar. Si calculamos errores de tiempo, todavía debemos decidir cuánto nos preocupa una desviación grande frente a varias pequeñas. Esa elección influye en lo que el entrenamiento favorece. El sistema optimiza un criterio que alguien escogió, con datos que alguien reunió.
Después viene la inferencia: aplicar el modelo preparado a un pedido nuevo. Entrenamiento e inferencia son etapas distintas. Una aplicación puede responder miles de veces sin volver a ajustar sus parámetros. Que reciba información nueva en una consulta no significa automáticamente que aprenda de forma permanente.
Esta distinción también ayuda al leer cómo funciona un modelo de lenguaje. Un texto dentro de la conversación puede influir en una respuesta sin convertirse por ello en una modificación del modelo. Conviene preguntar qué cambia en cada etapa, en vez de llamar aprendizaje a cualquier adaptación aparente.
El papel de las características
Una característica es una propiedad que utilizamos para representar cada ejemplo. En la entrega podría ser la distancia recorrida; en una canción, una medida de su contenido sonoro. Elegir características determina qué información tendrá disponible el modelo y qué diferencias podrá reconocer.
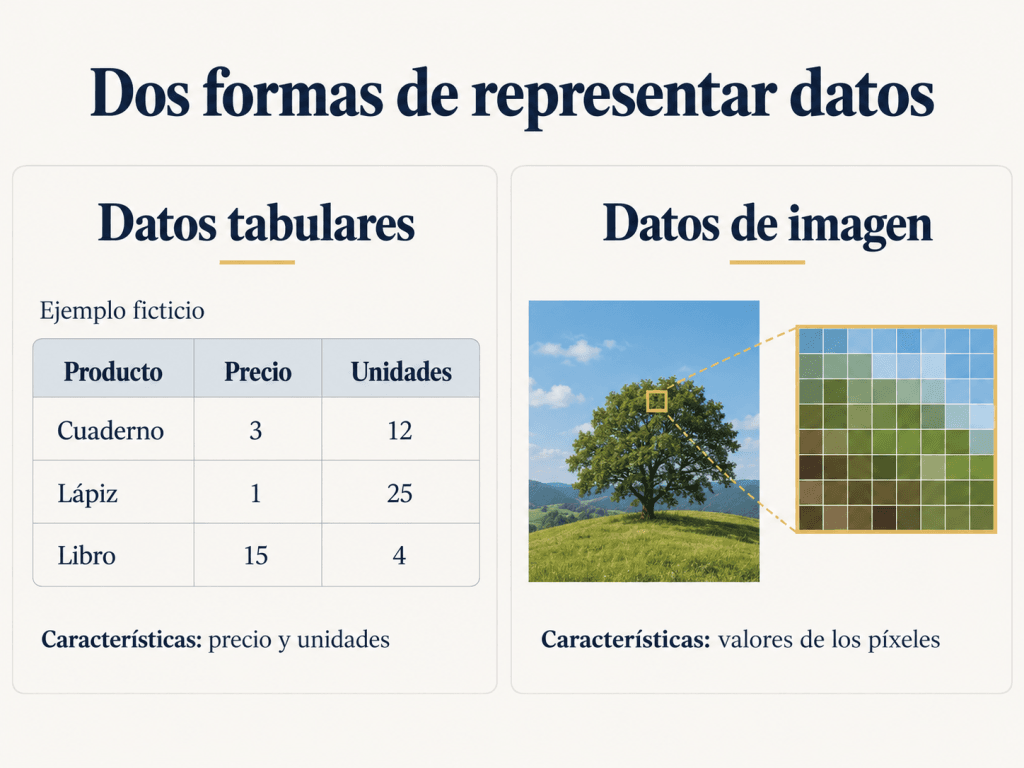
Imagina que queremos distinguir fotografías de cuadernos y libros. Podríamos preparar medidas del tamaño, la proporción entre lados y la presencia de espiral. Un algoritmo convencional buscaría relaciones entre esas medidas y las etiquetas. Antes de entrenarlo, una persona ya habría decidido qué aspectos de la imagen resumir.
Una red profunda puede aprender transformaciones sucesivas a partir de los píxeles. Algunas transformaciones detectan regularidades locales; otras combinan información para resolver la tarea. La introducción de IBM al aprendizaje profundo explica esta capacidad de aprender representaciones. Eso reduce parte del trabajo manual, aunque no elimina las decisiones humanas.
Todavía hay que definir el objetivo, seleccionar ejemplos, tratar errores y diseñar la evaluación. Además, muchas soluciones mezclan características preparadas manualmente con representaciones aprendidas. La oposición entre datos completamente crudos y datos completamente organizados sirve como aproximación inicial, pero deja fuera muchos sistemas reales.
Hay una consecuencia práctica: si una característica útil no aparece en los datos, el algoritmo no puede consultarla por voluntad propia. Una tabla de ventas que omite días de cierre puede confundir una tienda cerrada con una tienda sin demanda. Aumentar la profundidad de la red no repara automáticamente esa omisión.
Ejemplos de machine learning: un proyecto contado por dos caminos
Volvamos a la tienda. Quiere estimar ventas semanales para organizar sus pedidos. Puede comenzar con una referencia sencilla: usar las ventas de la semana anterior. Esa referencia proporciona un resultado con el que comparar alternativas. Un modelo sofisticado que no mejora una comparación razonable tiene una justificación pendiente.
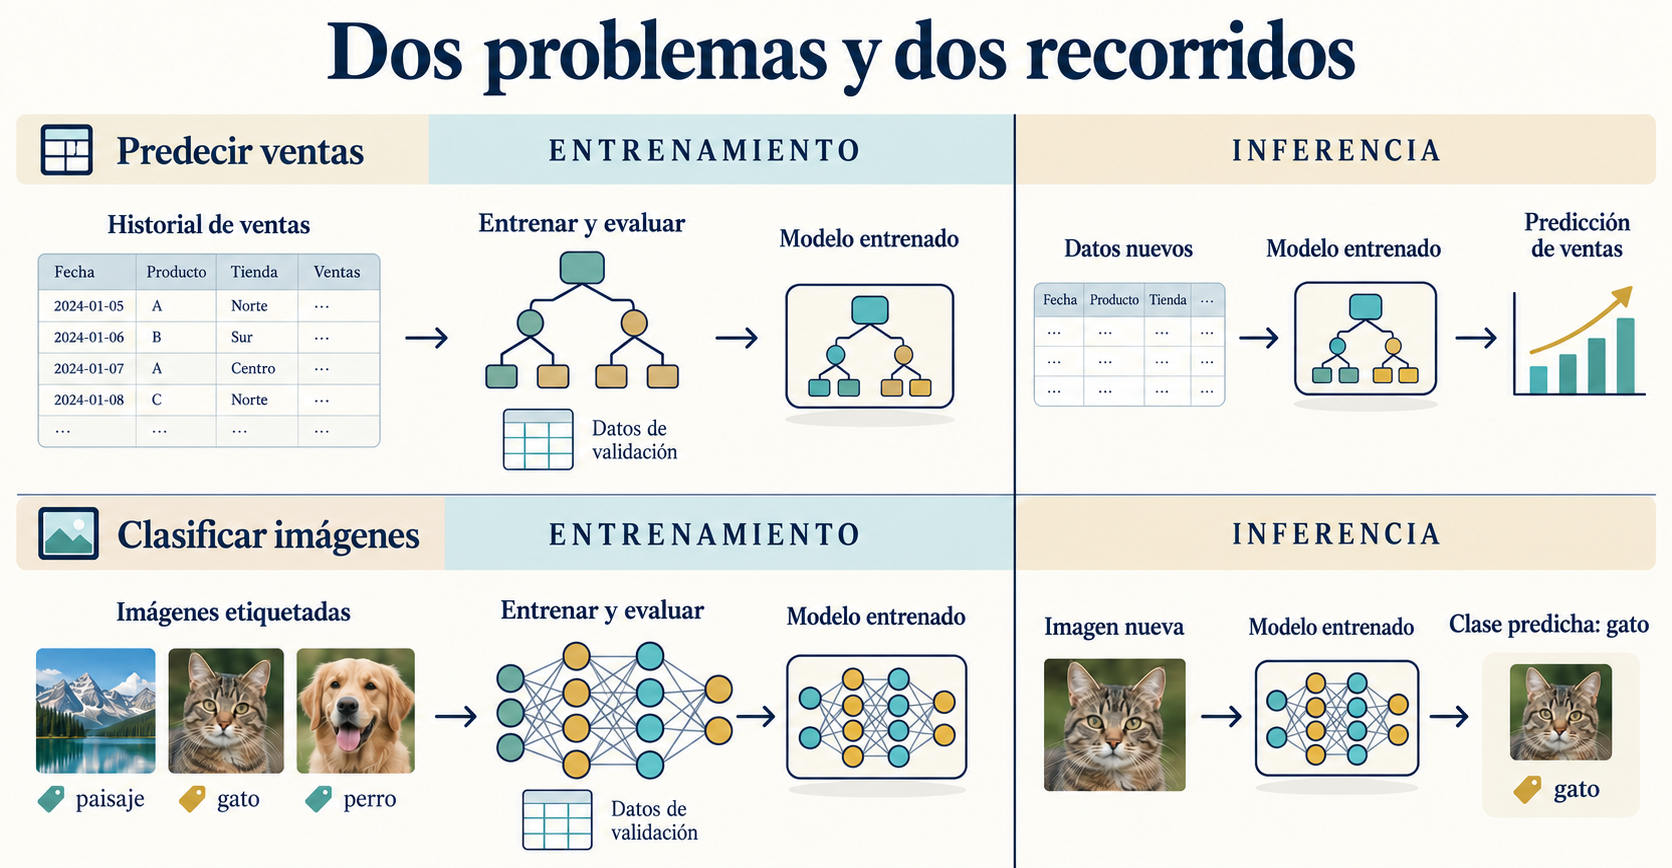
Después podría probar una regresión o un modelo basado en árboles con columnas de calendario, precio y ventas pasadas. El propósito es observar si esas entradas permiten mejorar la estimación en semanas nuevas. Este ejemplo es ilustrativo: no supone que hayamos medido resultados en una tienda real ni promete un método ganador.
Ahora imaginemos la aplicación que reconoce objetos en fotografías. Debe manejar cambios de iluminación, orientación y fondo. Preparar manualmente todas las características relevantes sería difícil. Una red profunda previamente entrenada para analizar imágenes puede ofrecer representaciones útiles que se adapten a la nueva clasificación.
Son dos decisiones apoyadas en la forma de los datos y en el trabajo disponible. El tamaño del negocio no determina por sí solo cuál es mejor. Una organización pequeña puede aprovechar un modelo preentrenado, mientras una organización grande puede resolver una tarea concreta con una regresión fácil de mantener.
También cambia la pregunta que hacemos al proveedor. Para la tabla de ventas interesa saber cómo utiliza el pasado sin acceder al futuro. Para las fotografías interesa conocer qué imágenes recibió y qué ocurre con fondos diferentes. Preguntar únicamente si utiliza Deep Learning deja sin revisar buena parte del problema.
Aprendizaje supervisado, no supervisado y por refuerzo
Estas expresiones describen otra dimensión del aprendizaje. En una tarea supervisada tenemos una señal con la que comparar la salida: por ejemplo, una fotografía y su categoría conocida. Ajustamos el modelo para que sus respuestas se acerquen al resultado esperado según el criterio elegido.
En una tarea no supervisada buscamos estructura sin disponer de esas respuestas para cada ejemplo. Podríamos agrupar canciones según semejanzas en sus representaciones. Los grupos obtenidos requieren interpretación: que un algoritmo separe elementos no demuestra que haya descubierto categorías naturales o culturalmente significativas.
En aprendizaje por refuerzo, un sistema aprende a escoger acciones a partir de recompensas y de sus consecuencias. Importa cómo una decisión modifica situaciones posteriores. Diseñar la recompensa es parte del problema: premiar una medida fácil de contar puede incentivar comportamientos que no cumplen bien el objetivo humano.
Estas modalidades no equivalen a convencional frente a profundo. Podemos usar redes profundas en tareas supervisadas y también dentro de sistemas por refuerzo. Asimismo, existen métodos no profundos para diferentes modalidades. Confundir ambos ejes produce frases engañosas, como decir que todas las redes necesitan etiquetas escritas una por una.
El aprendizaje autosupervisado obtiene señales de entrenamiento a partir de los propios datos. Ocultar una parte de un texto y pedir que se prediga es una idea ilustrativa. La arquitectura y el objetivo siguen siendo elecciones distintas: describir qué red utilizamos no basta para explicar de dónde procede la señal que la entrena.
Cómo saber si el modelo aprendió algo útil
Reservar ejemplos nuevos permite comprobar si el resultado se sostiene fuera del entrenamiento. En un proyecto habitual distinguimos datos de entrenamiento, validación y prueba. Los primeros ajustan parámetros; los de validación ayudan a elegir configuraciones; la prueba final estima el rendimiento después de esas elecciones.
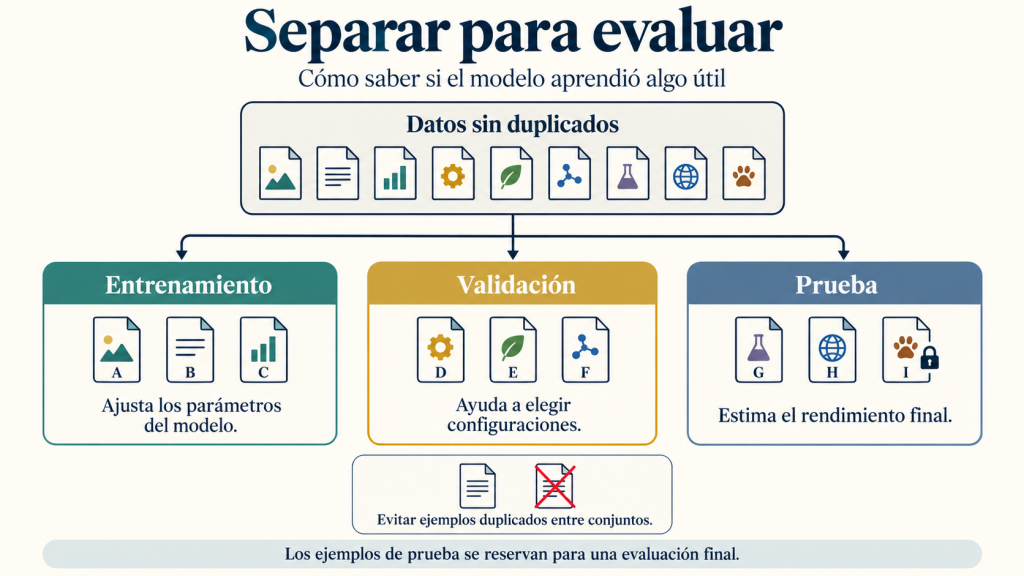
La documentación educativa de Google sobre división de conjuntos de datos explica por qué reutilizar continuamente la prueba para tomar decisiones debilita su valor. Podemos terminar adaptándonos a ese examen, aunque sus ejemplos nunca se hayan utilizado directamente para ajustar parámetros.
Para las ventas, mezclar semanas al azar puede ocultar el problema temporal. Si el uso real consiste en predecir el futuro, necesitamos una evaluación que respete qué información estaría disponible en cada momento. La separación adecuada depende del caso; no hay un porcentaje universal que garantice una buena prueba.
También debemos vigilar ejemplos relacionados. Si varias fotografías casi idénticas del mismo cuaderno aparecen a ambos lados de la separación, la evaluación puede resultar demasiado fácil. El sistema reconoce particularidades repetidas y parece generalizar más de lo que realmente generaliza. Separar archivos no siempre equivale a separar situaciones.
Un resultado útil debería incluir qué se midió, con qué ejemplos y frente a qué referencia. La cifra aislada pierde significado. Decir que una herramienta alcanza gran precisión sin aclarar el conjunto de prueba se parece a anunciar que un estudiante obtuvo excelente nota sin contar qué le preguntaron.
Sobreajuste y fuga de información
El sobreajuste aparece cuando un modelo se adapta demasiado a particularidades del entrenamiento y falla con casos nuevos. Puede suceder con redes profundas y con métodos convencionales. Una de sus señales es que el rendimiento de entrenamiento mejora mientras la evaluación independiente deja de mejorar o empeora.
Google desarrolla este problema en su explicación de sobreajuste y generalización. Limitar la complejidad o cambiar el entrenamiento puede ayudar, aunque primero debemos comprobar que los ejemplos y la evaluación representan el uso previsto. Una buena curva no arregla una pregunta mal planteada.
La fuga de información es un error diferente: utilizamos información que no estaría disponible al predecir. En el ejemplo de entregas, introducir una columna rellenada al cerrar el pedido podría revelar indirectamente su duración. El sistema parece acertar porque recibe una pista del resultado que debería estimar.
La documentación de scikit-learn sobre errores habituales advierte también sobre el preprocesamiento. Si calculamos transformaciones utilizando conjuntamente entrenamiento y prueba, dejamos que información de la prueba influya en la preparación. Debemos aprender las transformaciones con el conjunto permitido y aplicarlas después a los demás.
El peligro no siempre produce un fallo visible. A menudo genera un resultado demasiado bueno. Por eso conviene examinar con especial atención una mejora sorprendente: podría revelar una capacidad útil, pero también una separación defectuosa o una variable que entrega la respuesta por adelantado.
Por qué el porcentaje de aciertos puede engañar
Considera un ejemplo inventado: tenemos mil mensajes y solo diez son indeseados. Un clasificador que acepta todos obtiene novecientos noventa respuestas correctas, es decir, un 99 % de aciertos. Sin embargo, no detecta ninguno de los mensajes que queríamos detener.
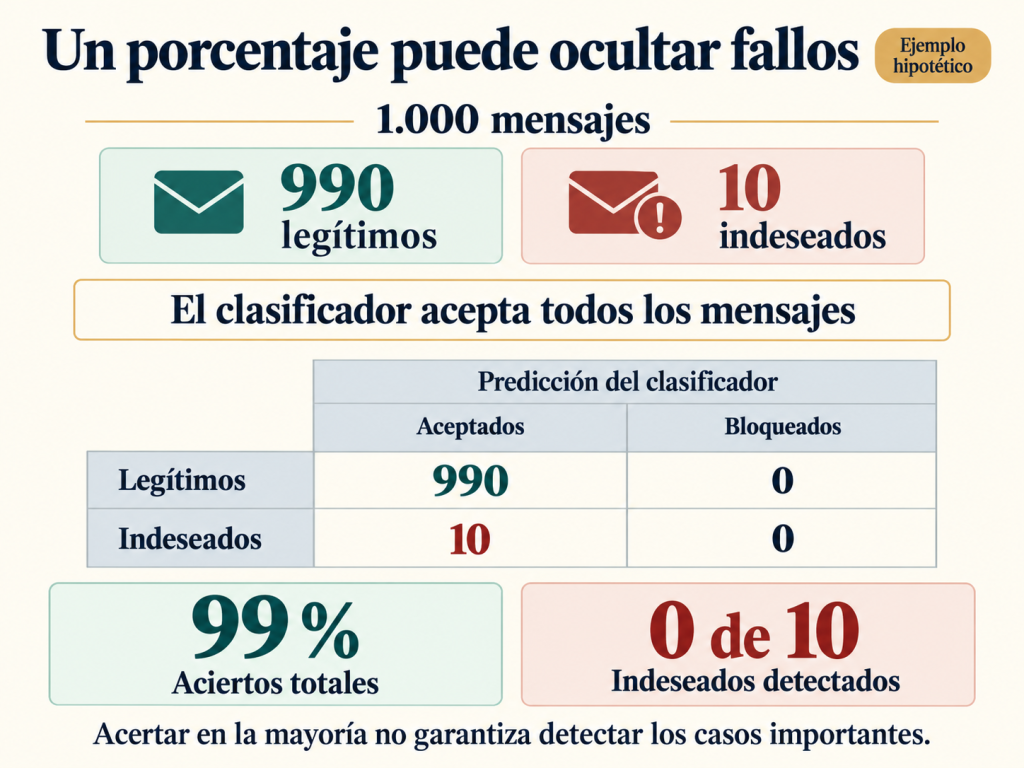
Podemos contar cuántas alertas fueron correctas y cuántos casos indeseados conseguimos encontrar. Son preguntas diferentes. También hay que valorar el costo de bloquear un mensaje legítimo frente al de dejar pasar uno molesto. La medida adecuada depende de la decisión que se tomará con el resultado.
Si dos modelos ofrecen porcentajes parecidos, pueden equivocarse en ejemplos distintos. Uno quizá falla con fotografías oscuras; otro, con objetos parcialmente tapados. Mirar grupos de errores permite descubrir limitaciones que un promedio oculta. Ese análisis puede conducir a reunir mejores ejemplos en vez de cambiar de arquitectura.
Las personas también buscamos confirmaciones cómodas. El artículo sobre sesgos cognitivos explica por qué una demostración convincente puede pesar más que varias pruebas menos llamativas. En una evaluación técnica conviene decidir de antemano qué resultado contaría como mejora y registrar también los fallos.
Una demostración comercial enseña posibilidades; una evaluación bien diseñada estima límites. Para comprobar las promesas de un asistente, el método de verificación de respuestas de IA añade otra precaución: contrastar el resultado con evidencia externa, especialmente cuando la salida parece segura y difícil de revisar.
Datos, cómputo y modelos preentrenados
Las redes profundas pueden requerir muchos datos y recursos para entrenarse desde cero. La cantidad necesaria depende de la tarea y del conocimiento que ya incorpore el modelo. Por eso conviene distinguir construir un sistema nuevo de adaptar o utilizar uno preparado previamente.
La transferencia aprovecha representaciones aprendidas en una tarea para trabajar en otra. En las fotografías de cuadernos, podríamos reutilizar parte de un modelo visual y ajustar componentes específicos. Ese punto de partida reduce trabajo, pero exige comprobar si su preparación resulta adecuada para los objetos y condiciones actuales.
Usar un modelo preentrenado también introduce dependencias. Hay que revisar su licencia, el formato de las entradas y las condiciones de funcionamiento. Una solución que requiere conexión constante puede resultar incómoda donde la señal falla. Otra que funciona localmente puede exigir más memoria de la que tiene el dispositivo previsto.
El costo tampoco termina al entrenar. Procesar cada nueva solicitud consume recursos; almacenar datos y mantener el sistema requiere trabajo. Si una solución convencional cumple la tarea con menos esfuerzo, esa ventaja forma parte de su calidad. Si una red mejora claramente el resultado, podemos valorar si la diferencia justifica sus exigencias.
Para decidir, resulta útil preparar un pequeño presupuesto del proyecto con ejemplos reales de uso. ¿Cuántas solicitudes habrá? ¿Cuánto puede tardar una respuesta? ¿Quién revisará errores? Esas restricciones permiten comparar alternativas con sentido y evitan elegir una tecnología por la vistosidad de su nombre.
Una ruta razonable para empezar
Define primero una salida comprobable. Estimar ventas para organizar pedidos es una tarea más concreta que mejorar el negocio con inteligencia artificial. A continuación, identifica qué datos estarán disponibles al responder y qué decisión dependerá de la predicción. Esas dos preguntas evitan objetivos vagos y variables imposibles.
Construye una referencia sencilla y conserva ejemplos para evaluarla. Si la información viene en una tabla, probar un método convencional puede aportar una comparación barata y comprensible. Si trabajas con imágenes o audio, estudiar modelos preentrenados puede ahorrar una preparación que no necesitas repetir.
Documenta después los errores que importan. Una clasificación general puede funcionar y aun así fallar precisamente con el objeto que más interesa. También conviene establecer cuándo una persona debe revisar el resultado. Automatizar una predicción y automatizar la decisión completa son responsabilidades diferentes.
Cuando el sistema entre en uso, habrá que comprobar si los datos cambian. Un catálogo nuevo, otra cámara o modificaciones en los hábitos de compra pueden alterar el rendimiento. El modelo se prepara con un registro del mundo; ese registro envejece aunque el archivo siga abriéndose sin problemas.
Una prueba pequeña antes de automatizar
Imagina que la tienda del principio decide ensayar la estimación sin modificar todavía sus pedidos. Durante varias semanas registra lo que habría recomendado el modelo y lo compara con las ventas observadas. Ese ensayo permite revisar consecuencias sin confundir una predicción prometedora con una política de compras ya aprobada.
Si el modelo propone menos cuadernos de los necesarios, pueden perderse ventas. Si propone demasiados, queda inventario. Dos errores del mismo tamaño tienen efectos distintos según el producto y el momento. La persona responsable debe establecer cómo compararlos; esa preferencia no aparece espontáneamente dentro de los datos.
También conviene dejar un registro de las condiciones del ensayo. Una promoción especial o un cierre inesperado pueden explicar un error y ayudar a decidir qué información falta. Anotar esas circunstancias no autoriza a borrarlas después para embellecer el resultado. Si volverán a ocurrir, pertenecen al problema que queremos resolver.
Al terminar, la tienda puede decidir seguir con la referencia sencilla, adoptar el modelo o reunir información adicional. Las tres son decisiones válidas cuando se apoyan en la prueba. El aprendizaje del proyecto incluye descubrir que una herramienta todavía no aporta suficiente mejora. Esa conclusión ahorra trabajo y deja una comparación honesta para el siguiente intento.
Preguntas frecuentes
¿Necesito saber programar para aprender estos conceptos?
Puedes comprender qué son los datos, el entrenamiento y la evaluación sin escribir código. Programar ayuda cuando quieres preparar ejemplos, probar modelos y revisar resultados por tu cuenta. Un buen comienzo es describir una tarea concreta y construir una comparación sencilla. Así aprenderás para qué sirve cada herramienta antes de ocuparte de su sintaxis.
¿Una computadora común sirve para empezar?
Sí, permite trabajar con conjuntos pequeños y muchos métodos convencionales. También puedes utilizar algunos modelos preentrenados, según su tamaño y los recursos del equipo. Entrenar redes grandes desde cero plantea otras exigencias. Para aprender, conviene ajustar la escala del ejercicio al dispositivo disponible y medir sus tiempos antes de comprar equipo.
¿Un modelo que ya está entrenado sigue aprendiendo al usarlo?
No necesariamente. Durante la inferencia puede procesar entradas nuevas manteniendo fijos sus parámetros. Algunas aplicaciones incorporan actualizaciones o almacenamiento externo, pero eso depende de su diseño. Para saber qué ocurre, revisa si cambia el modelo, si guarda información en una base de datos o si únicamente utiliza el contexto de la solicitud actual.
¿Puedo utilizar datos de internet para mi proyecto?
Que un archivo sea accesible no implica que puedas utilizarlo para cualquier propósito. Revisa permisos, licencia y condiciones de uso; si contiene información personal, considera también las obligaciones aplicables. Para un ejercicio inicial, un conjunto educativo con documentación clara permite concentrarte en aprender sin perder de vista de dónde salen los ejemplos.
¿Qué debería aprender antes de entrenar una red profunda?
Conviene manejar tablas, nociones de probabilidad y medidas de error, además de entender entrenamiento y evaluación. Aprender a detectar duplicados y datos ausentes resulta muy útil. Puedes avanzar mediante proyectos pequeños. El primer objetivo razonable es explicar por qué confías en una prueba y reconocer cuándo su resultado todavía no demuestra utilidad.
Fuentes y lecturas recomendadas
- IBM. Qué es el aprendizaje automático: https://www.ibm.com/think/topics/machine-learning
- IBM. Qué es el aprendizaje profundo: https://www.ibm.com/think/topics/deep-learning
- Google for Developers. División de conjuntos de datos: https://developers.google.com/machine-learning/crash-course/overfitting/dividing-datasets
- Google for Developers. Sobreajuste: https://developers.google.com/machine-learning/crash-course/overfitting/overfitting
- scikit-learn. Errores habituales y prácticas recomendadas: https://scikit-learn.org/stable/common_pitfalls.html
Sigue explorando en Ciencia del Asombro
- Cómo funciona un LLM: 10 claves para entenderlo sin jerga técnica
- Cómo verificar una respuesta de inteligencia artificial sin ser experto
- El futuro del trabajo en la era de la IA
- Computación cuántica explicada sin fórmulas: qué es un qubit